城镇排水管网数字化通用技术要求》国标排水监测内容解读—智慧排水之乱弹(187)
小编按:首部关于排水管网数字化的国标来了,监测感知是排水数字化的核心底座,我们来一起看看国标GB/T 47884对监测感知的定位、具体要求、数值性指标和参考价值。大家一起使用专业化的设备采集有效数据,保证监测数据质量,才能促进排水数字化的价值发挥。
一、国标来了,排水监测人为什么值得读一遍
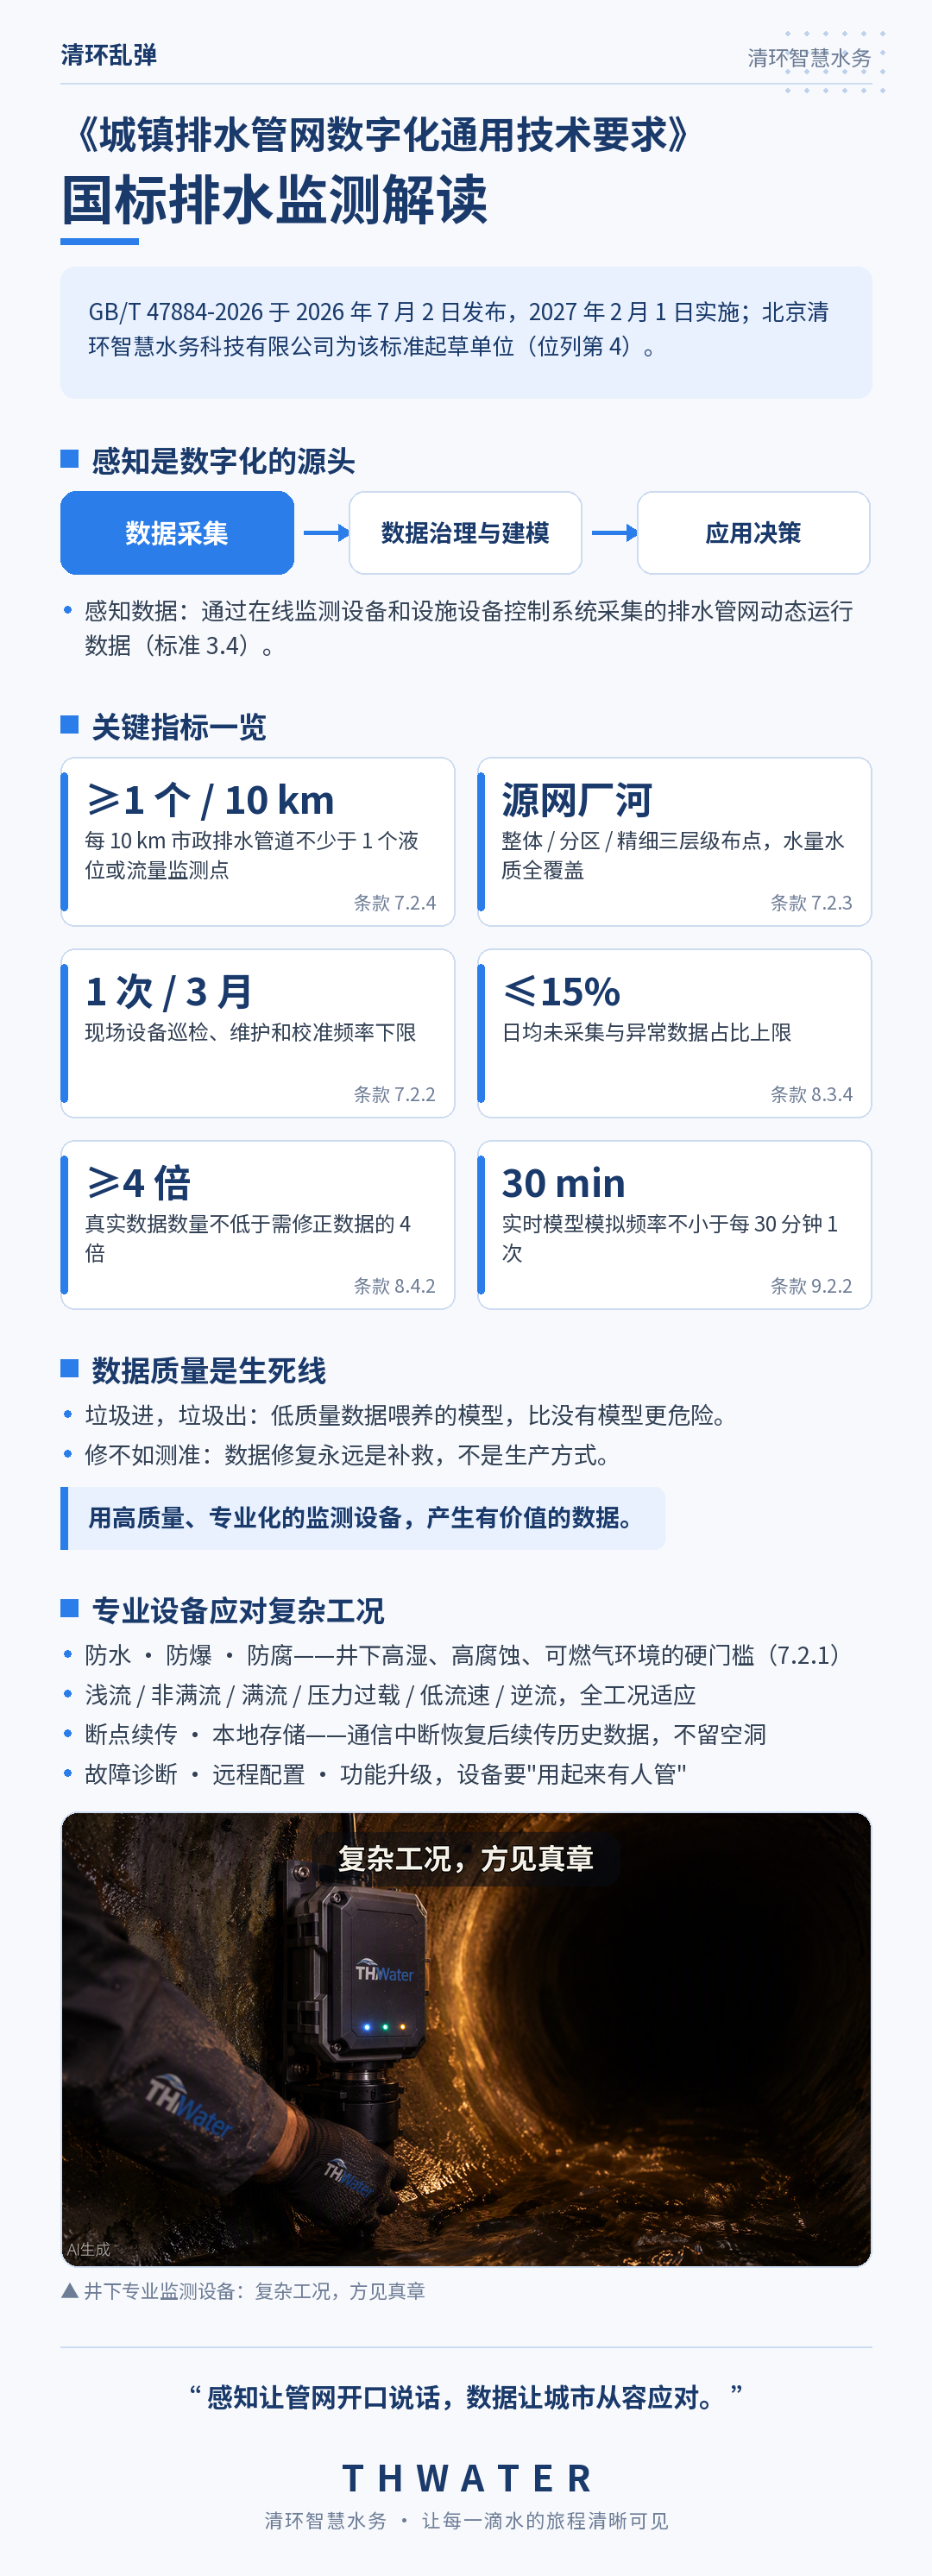
2026年7月2日,国家市场监督管理总局和国家标准化管理委员会发布了 GB/T 47884-2026《城镇排水管网数字化通用技术要求》,2027年2月1日正式实施。喜欢看视频的可以看看老赵的解读,浏览量还是比较大滴。【清环参编的排水数字化国标发布:排水数字化从"感知"开始】
做排水数字化的同行这些年应该都有同感:项目越来越多,口径越来越乱。有的地方把"数字化"理解成买块大屏,有的地方把"智慧水务"理解成堆一堆传感器然后没人看数据。这个标准的价值,就在于它第一次用国标的口吻回答了一个基本问题:排水管网数字化,到底从哪儿开始、按什么规矩做。
北京清环智慧水务科技有限公司是这项国家标准的起草单位之一(20 家起草单位中位列第 4)。作为参与编写和讨论过条款细节的一方,特别是主要负责了感知部分内容,我们读这份标准的视角可能和纯读者不太一样——很多条款背后,是被工程项目反复教育出来的教训。这篇文章,就挑国标中的监测相关的条款,聊聊"标准为什么这样写"。
先亮三个清环团队的核心观点:
1. 感知是排水管网数字化的基础。 没有可靠的专业感知,数据治理、模型、决策全是无源之水。
2. 数据质量决定数字化的上限。垃圾进、垃圾出,低质量数据喂养的模型比没有模型更危险、最后可能大家都不相信数字化技术。
3. 一定要用高质量、专业化的监测设备产生有价值的数据。 廉价不可靠的设备产生的不是数据,是垃圾,是负担,是对现场的猜测,是对资源的浪费。
下面逐条用标准原文和背后的专业逻辑来佐证。
二、读懂国标的底层逻辑:感知在源头
标准 3.4 条给"感知数据"下了定义:
"通过在线监测设备和设施设备控制系统采集的排水管网动态运行数据。"
这句话看着平淡,但它在标准总体架构里的位置很关键。标准把数字化拆成了一条链路:数据采集 → 数据治理与建模 → 应用决策。注意这个顺序——采集在最前面,是源头;治理、建模、决策,全部是下游,如果上游原料就有问题,那么下游的产品不可能是高质量的。
这意味着什么?意味着下游所有环节的成色和质量,都被源头锁死了。数据治理手段再高明,治理的也是采集来的东西;专业模型再精巧,喂进去的还是那批数。源头如果稀薄、失真、断流、错误,后面每一个环节都在放大这个缺陷,最终会导致数字化以失败告终。
所以第一个观点不是口号,是架构事实:感知是排水管网数字化的基础。见过一些数字化项目,预算大头砸在可视化平台和高科技模型上,监测点位凑凑数,监测厂家也敢纸面承诺参数达标,最后模型跑出来的结果和现场对不上,回头一查,源头数据根本撑不住。标准把采集放在链路第一环,就是在制度层面堵住这种"头重脚轻"的玩法。【排水监测:需求很刚性、市场很分散、竞争很原始、行业很受伤】
图1 城市地下管网数字孪生总览
三、布点怎么布:10 公里 1 个点和"源网厂河"三层级
感知要落地,先解决"在哪测"的问题。标准给了两层约束。
第一层是原则。7.1.4 条:
"在线监测点位的布设应遵守系统性、代表性、有效性、可行性和积极性的原则。"
五个词都不是摆设。"系统性"说的是点位要成网,不能哪儿好装装哪儿;"代表性"说的是测的位置要能代表管段的真实状态,在每个测得数据能代表该点位的真实指标【排水管道流量测量:都叫多普勒,售价差别为何从1万到20万?】;"有效性"和"可行性"是老工程师的护身符——井下能不能装、装了能不能维护,都是硬约束。【同样是排水管网监测仪表,为啥有的能用3年,有的3个月就坏?】
第二层是量化底线。7.2.4 条:
"每 10 km 市政排水管道应布设不少于 1 个液位或流量监测点位,同时应在重要排水户和重要节点进行监测"
"每 10 km 不少于 1 个",这是底线不是目标、更不是每个地方照抄的布点密度。真正决定监测体系水平的,是 7.2.3 条提出的框架:监测应覆盖"源、网、厂、河",按整体监测、分区监测和精细监测三个层级开展【在线监测方案制定的6个原则—智慧排水之乱弹(131);监测布点的典型错误认识与正确打开方式—智慧排水之乱弹(103)】。此外 7.2.5 条还要求如果开展水质监测工作,可对化学需氧量、悬浮物等重要指标开展在线监测,而其他指标更经济有效的方法则是自动区域化验——也就是说,水量之外,水质也要进监测体系,但是要讲究投入产出比【水质采样怎么做?TWS来帮忙!—智慧排水之乱弹(101)】。
这套逻辑的工程含义是:布点不是均匀撒芝麻,而是分层答题,而是动态调整。整体层级回答"系统负荷怎么样",分区层级回答"哪个片区出了问题",精细层级回答"这个排口、这段管道到底发生了什么"。三层各司其职,点位才有意义。只在一个层级堆密度,钱花了,问题照样答不上来。同时,可以用租用临测的方式,来提高监测设备的利用率【排水监测到底是买设备还是租服务?】。
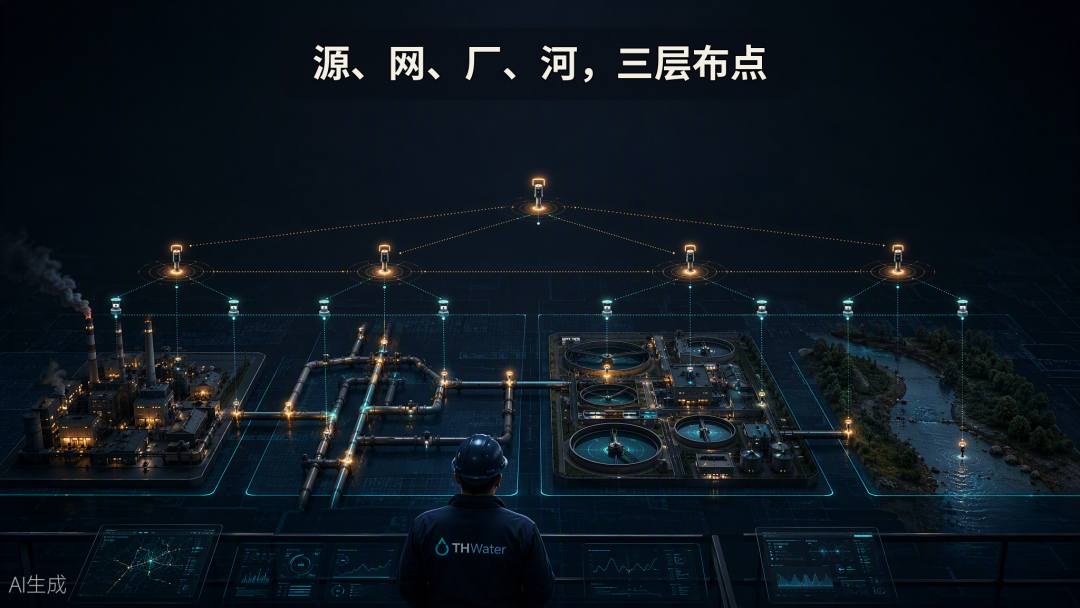
图2 源网厂河三层级布点示意
四、设备怎么选:7.2.1 逐条读每一条都是坑换来的
到了设备层面,标准写得异常具体。7.2.1 条的要点包括:
• 设备适应实际工况长时间稳定可靠运行;
• 防水、防爆、防腐,防护等级和安全性足够应对恶劣工况;
• 满足浅流、非满流、满流、管道压力过载、低流速、逆流等工况要求,技术原理必须满足排水工况,而不是拿一个稳定工况下的实验室探头装上去;
• 具备监测数据本地化存储功能,通信中断恢复后续传历史监测数据。
外行看这是一份参数清单,内行看这是一份"事故清单"。逐条说:
工况这条现场翻车最多。 排水管道不是实验室,浅流时流速低到很多流量计直接失效,非满流和满流的水力学条件完全不同,暴雨期间还可能压力过载、甚至逆流。一台只能测"标准工况"的设备,在最需要数据的关键时刻大概率掉链子——而关键时刻的数据恰恰最值钱。【国家新规要求”强化监测预警”:排水监测装了一堆非专业设备,最后全是沉默成本。】
断点续传这条,是被通信环境差教育出来的。 井下信号本来就差,如果水淹屏蔽后可能就断联,通信中断是常态不是意外。没有本地存储和续传能力,中断的那几小时就是永久数据空洞,后面做率定、做复盘,永远缺一块。
防水防爆防腐更不用多说。 排水井下是高湿、高腐蚀、存在可燃气体的恶劣环境,防护等级不够的民用级设备下去,寿命按周算。
这就是我们的第三个观点:一定要用高质量、专业化的监测设备产生有价值的数据。廉价设备省下的采购费,会以运维费、数据修复费、错误决策成本的形式加倍还回来。它产生的不是数据,是负担。【监测行业怪象:先用好设备→换低价虚标→返工重选,为何总在走弯路?】
顺带说一句自家实践:清环的 THWater 系列监测设备,在设计目标上就是对着这些条款去的——覆盖浅流、非满流、满流、逆流的复杂工况,本地存储加断点续传,高防护等级适应井下环境,再加上配套的巡检运维体系。这不是巧合,参与起草的过程,本质就是把多年工程现场里踩过的坑,一条一条写进标准要求里。【清环助力排水物联设备大规模更新和高质量建设运行】
标准还要求设备"用起来要有人管"。7.2.2 条:
"应对现场监测设备进行巡检、维护和校准,频率不小于每 3 月 1 次。"
每 3 个月至少一次巡检校准,意味着设备选型时就要算运维账:好不好操作、好不好校验、故障了能不能远程诊断。设备是监测体系的一部分,运维体系也是。【规范运维是监测设备正常运行的根本—智慧排水之乱弹(86)】
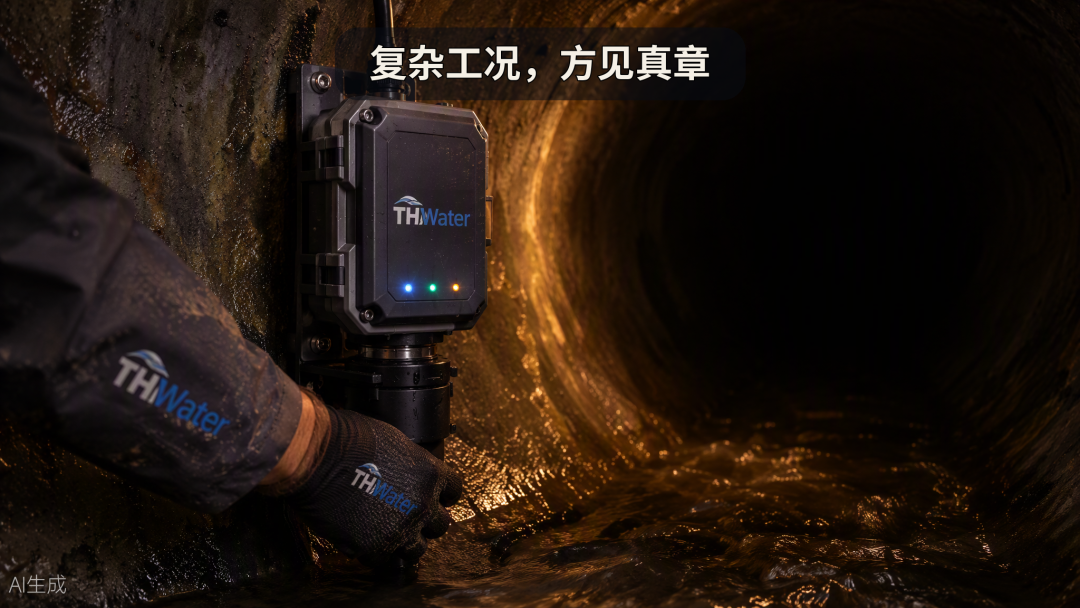
图3 井下专业监测设备特写
五、数据质量的生死线:15% 与 4 倍
这一节是全篇最该划重点的地方。标准里藏着两个数字,一个管"缺多少",一个管"修多少"。第一个数字,8.3.4 条:
"监测期内,日均未采集数据和异常数据的总数应不大于应监测数据总数的 15%。"
15% 是数据可用性的红线。换句话说,一套在线监测体系如果三天两头掉线、异常值满天飞,它连"合格的数据供给方"都算不上,下游的一切功能免谈。
第二个数字更扎心,8.4.2 条:
"为保障数据规律的真实性,使用的真实数据数量应不低于需要修正数据数量的 4 倍"
读懂这条了吗?它的潜台词是:数据修复是有配额制的。 你想在后期处理中修 1 条数据,得先拿出 4 条真实数据作直接依据。修太多,配额不够,剩下的只能作废。工程上我们常说一句话:修不如测准。 这条标准相当于用数字把这句话钉死了——修复永远是补救,不是生产方式。靠后期修复撑起来的数据集,规律性是可疑的,真实性是打折的,分析结果也是不可信的。
这就是第二个观点的标准版表述:数据质量决定数字化的上限。 垃圾进、垃圾出;更要命的是,低质量数据喂养的模型不会喊疼,它只会安安静静地给出错误答案,比没有模型更危险——没有模型的人至少知道自己不知道。
图4 优质数据与垃圾数据对比
六、感知数据的终点:喂给模型和决策,支持排水管理
数据采好、管好,最终要干活。标准第 9 章讲模型,对感知数据提出了直接的能力要求。
9.2.2 条要求:实时模型模拟频率每 30 min 不小于 1 次。这意味着感知数据流必须是连续、准实时的——半小时一刷新的模型,靠人工抄表和三天一掉线的设备根本喂不饱。
9.3条讲率定验证:旱天率定采用不少于 7 d 连续无降雨监测数据;雨天率定应包含不少于 3 场不同强度降雨。注意"连续"和"不同强度"这两个词。7 天连续无降雨数据,中间断一天就得重熬;3 场不同强度降雨,意味着设备必须在从小雨到暴雨的全谱系工况下都活得下来、测得准。这又回到了第四章——复杂工况适应性不是加分项,是模型时代的入场券。
整条链路到这里闭环了:感知 → 数据治理 → 模型 → 决策,环环相扣,而源头始终是感知。感知扎实,模型才有粮食,决策才有底气;感知稀烂,后面全是空中楼阁。
图5 智慧水务平台决策大屏
七、最后的建议
这本国家标准2027年2月1日实施,留给排水行业消化的时间不算长。最后说三句大实话:
第一,把感知当基础设施看,而不是当项目配套看。 它是数字化链路的第一环,也是上限的设定者,必须要用专业的设备和专业的人员。
第二,数据质量是红线思维。 15% 和 4 倍这两个数,值得打印出来贴在每个监测项目的方案上,并在过程中盯住了。
第三,设备上省的钱,数据会替你付出去。 专业设备产生的数据是资产,廉价设备产生的"数据"是垃圾、是负债——资产负债表,其实写在井里。